
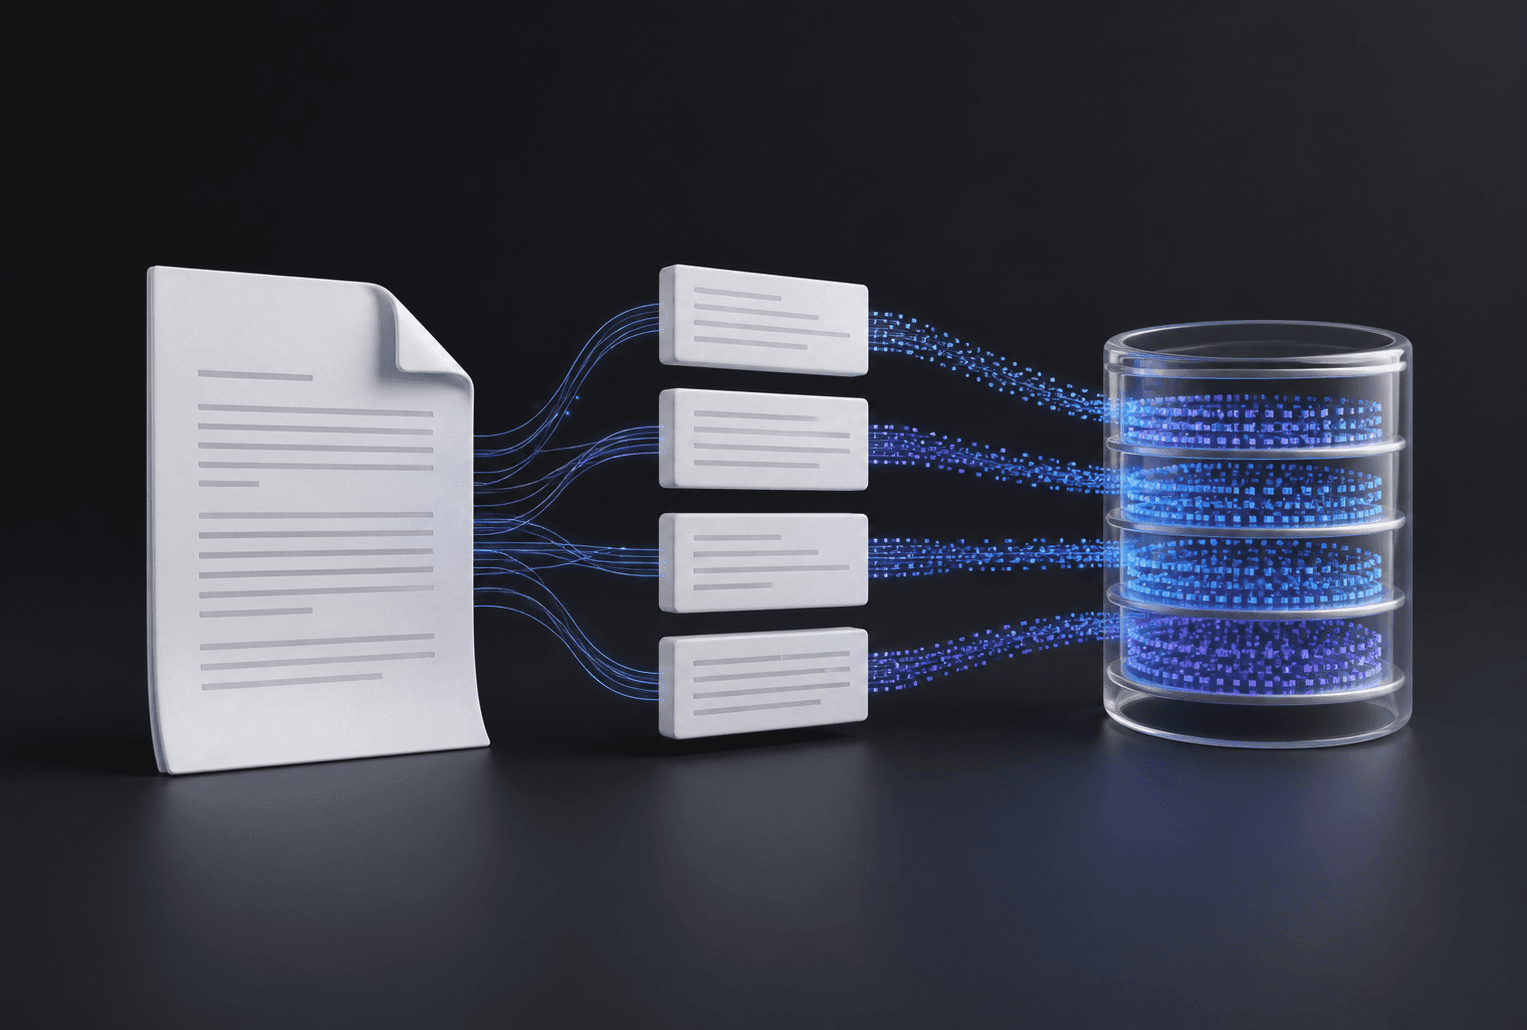
RAG는 Retrieval-Augmented Generation의 약자로 ‘검색 증강 생성’이라고 한다. 쉽게 말해 사용자가 질문하면 지식 베이스에서 관련 정보를 찾고, 그 정보를 바탕으로 답변을 생성하는 방식이다.
GPT나 Claude는 회사 내부 문서와 비공개 자료에 대해서는 제대로 답변하기 어렵다. 하지만 RAG를 연결하면 질문과 관련된 내부 문서를 찾아 LLM에 전달할 수 있어 이러한 한계를 보완할 수 있다.
RAG와 함께 자주 언급되는 방법으로 Fine-Tuning을 통해 모델을 추가로 학습시키는 방법도 있다. 다만 회사 문서처럼 내용이 계속 바뀌는 지식을 관리하기에는 비용과 시간이 많이 들어간다. Fine-Tuning은 답변의 형식과 말투, 특정 업무를 수행하는 방법을 학습시키는 데 적합하고, RAG는 문서에서 필요한 정보를 찾아 답변하게 만드는 데 적합하다고 이해하면 된다.
RAG 파이프라인 구조
RAG는 간단하게 다음과 같은 구조로 구성된다.
- 문서의 내용을 추출한다.
- 문서를 청크(Chunk)로 자른다.
- 각 청크를 임베딩(Embedding)으로 변환한다.
- 변환한 결과를 벡터 DB에 저장한다.
- 사용자 질문이 들어오면 질문도 임베딩한다.
- 질문과 관련 있는 청크를 찾는다.
- 찾은 청크를 LLM에 전달한다.
- LLM이 전달받은 청크를 바탕으로 답변한다.
정리하면 다음과 같다.
문서 추출 → 청킹 → 임베딩 → 벡터 DB 저장 → 질문 → 검색 → 답변
기본 구조는 단순하지만, 중간중간 검색 품질을 높이기 위해 Reranking, Query Transformation 등 여러 기법이 사용된다. 이번 글에서는 문서를 추출하고 청크로 나눈 뒤 벡터 DB에 저장하는 단계까지 알아보려고 한다.
Chunking과 Chunk
청크(Chunk)는 문서를 나눈 작은 정보 조각이고, 청킹(Chunking)은 청크를 만드는 과정이다. 청크를 어떻게 나누느냐에 따라 검색 품질이 크게 달라진다.
예를 들어 800자로 구성된 하나의 설명을 500자 단위로 자른다고 가정해보자. 첫 번째 청크에는 질문의 배경이 들어가고, 두 번째 청크에는 실제 결론이 들어갈 수 있다. 검색 과정에서 둘 중 하나만 선택된다면 답변에 필요한 내용이 빠질 수 있다.
그럼 문단 단위로 나누면 되는 것 아니냐? 라는 물음이 생기는데, 10페이지 정도의 문서라면 직접 문단을 확인하면서 나눌 수 있다. 하지만 수십 권에서 수천 권에 달하는 문서를 처리한다면 이야기가 달라진다. 문서마다 문단의 길이와 구조가 다르고, PDF에서 보이는 줄바꿈이 실제 문단과 일치하지 않을 수도 있다. 표와 이미지, 각주가 본문 사이에 들어가는 경우도 있다.
결국 핵심은 청크의 크기를 일정하게 만드는 것이 아니라, 답변에 필요한 의미와 맥락의 손실을 줄이는 것이다.
의미 기반 청킹
의미 기반 청킹(Semantic Chunking)은 글자 수만 보고 문서를 자르는 것이 아니라 문장의 뜻을 보면서 자르는 방식이다.
쉽게 말해 문서를 먼저 문장 단위로 나눈 뒤 앞뒤 문장이 비슷한 이야기를 하고 있는지 비교한다. 같은 이야기가 계속 이어지면 하나의 청크로 묶고, 주제가 달라지는 지점에서 새로운 청크를 만든다. 예를 들어 한 문서가 주택담보대출의 정의를 설명하다가 대출 신청 자격이나 금리 계산 방식으로 주제를 바꾼다면, 문장 사이의 의미 변화가 커지는 지점을 기준으로 청크를 나눌 수 있다.
의미가 비슷한 문장을 무조건 하나로 묶는다는 뜻은 아니다. 일반적인 의미 기반 청킹은 문서의 순서를 유지하면서 인접한 문장 사이의 변화 지점을 찾는다. 문서의 1페이지와 100페이지에 비슷한 내용이 있다고 해서 두 내용을 자동으로 하나의 청크로 합치는 방식은 아니다.
다른 청킹 방식
문서의 종류에 따라 다음과 같은 청킹 방식도 사용할 수 있다.
-
고정 크기 청킹(Fixed-size Chunking)
문서를 정해진 글자 수나 토큰 수로 나눈다. 빠르고 간단하지만 문장 중간이 잘릴 수 있다. -
재귀적 청킹(Recursive Chunking)
제목, 문단, 문장과 같은 문서의 구조를 순서대로 확인하며 나눈다. 문단이 너무 크면 문장으로 나누고, 문장도 너무 크면 더 작은 단위로 나누는 방식이다. -
청크 오버랩(Chunk Overlap)
이전 청크의 마지막 내용을 다음 청크에도 조금 포함한다. 청크 경계에서 문맥이 끊기는 문제를 줄일 수 있지만 같은 내용이 중복으로 저장된다. -
Late Chunking
문서 전체의 문맥을 먼저 임베딩한 뒤 청크 단위로 나눈다. 청크만 따로 임베딩하면서 앞뒤 내용을 잃는 문제를 줄이기 위한 방법이다. 자세한 내용은 Late Chunking 논문에서 확인할 수 있다.
최근에는 여러 청킹 방식을 조합하는 MoC(Mixture-of-Chunkers)라는 방법도 발표됐다. MoC는 하나의 방식으로 문서를 바로 자르지 않고, 여러 Chunker가 문서를 서로 다른 크기로 분석하며 청크의 경계를 찾는 방식이다.
쉽게 말하면 먼저 문서를 큰 단위로 살펴보고, 다시 작은 단위로 살펴보면서 어디에서 잘라야 하는지를 찾는 것이다. 아직 일반적으로 사용되는 표준 방식이라기보다는 연구에서 제안된 방법이다. 자세한 내용은 MoC 논문에서 확인할 수 있다.
Parser
그럼 이제 문서를 청킹한다는 것은 알았다. 그럼 이제 다음은 청킹을 하기 위해 PDF로 존재하는 자료를 '추출' 해야된다. Parser가 PDF와 같은 문서에서 텍스트부터 표, 이미지 등을 추출하는 도구라고 이해하면 된다.
문서는 글자로만 구성되어 있지 않다. 제목과 본문, 표와 이미지가 섞여 있고 스캔한 PDF는 페이지 전체가 이미지로 저장되어 있을 수도 있다. 따라서 문서의 종류에 따라 다른 Parser를 사용한다.
-
PyMuPDFLoader
PDF에서 글자를 빠르게 추출하는 방식이다. 텍스트 위주의 문서를 대량으로 처리하기 좋지만 복잡한 표와 이미지를 읽는 데는 한계가 있다. 보고서 본문을 빠르게 추출할 때 사용할 수 있다. 자세한 내용은 LangChain의 PyMuPDFLoader 문서에서 확인할 수 있다. -
PyMuPDF4LLM
PDF 내용을 Markdown이나 JSON 형태로 변환한다. 제목과 문단, 목록과 표 같은 문서 구조를 살리기 때문에 LLM이 읽기 좋은 형태로 만들 수 있다. 이미지가 전달하는 의미까지 이해하는 데는 한계가 있다. 자세한 내용은 PyMuPDF4LLM 공식 문서에서 확인할 수 있다. -
VLM
PDF 페이지를 이미지처럼 보고 내용을 읽는 방식이다. 글자뿐만 아니라 표와 이미지, 차트도 함께 이해할 수 있다. 다만 페이지마다 AI 모델을 사용하기 때문에 비용이 높고 처리 속도가 느리다.
아주 단순하게 정리하면 텍스트 위주의 문서는 PyMuPDFLoader, 문서의 제목과 표 구조가 중요하면 PyMuPDF4LLM, 이미지와 차트의 내용까지 읽어야 한다면 VLM을 사용할 수 있다.
Embedding
문서를 추출하고 청크로 나눴다면 다음은 청크를 숫자로 변환하는 단계다.
컴퓨터는 문장의 의미를 사람처럼 바로 이해하지 못한다. 따라서 청크의 특징과 의미를 숫자의 배열인 벡터(Vector)로 변환한다. 이 과정을 임베딩(Embedding)이라고 한다.
그리고 변환된 숫자 배열의 길이를 차원(Dimension)이라고 한다. 일반적으로 차원이 높을수록 더 많은 정보를 담을 수 있어 정확도는 올라가지만, 계산해야 할 숫자도 많아져 검색 속도는 내려간다.
Dense Embedding
Dense Embedding은 문장 전체의 의미를 기준으로 텍스트를 숫자로 변환하는 방식이다.
예를 들어 다음 두 문장은 사용하는 단어가 다르다.
- 아이폰 배터리가 너무 빨리 닳는다.
- 애플 스마트폰의 전원이 오래가지 않는다.
하지만 두 문장 모두 아이폰 배터리 문제에 대한 내용이다. Dense Embedding은 단어가 정확히 일치하지 않더라도 뜻이 비슷하면 가까운 숫자로 변환한다. 즉, Dense Embedding은 말은 달라도 뜻을 알아듣는 사람이라고 이해하면 된다. 의미 기반 청킹과 벡터 DB 검색에서 많이 사용된다.
Sparse Embedding
Sparse Embedding은 문장에서 중요한 단어를 중심으로 숫자로 변환하는 방식이다. 전체 숫자 배열 가운데 실제 값이 들어 있는 부분은 적고 대부분이 0이기 때문에 ‘희소하다’는 의미의 Sparse라는 이름을 사용한다.
Sparse Embedding은 제품명과 오류 코드, 사람 이름, 법률 조항처럼 정확한 단어가 중요한 검색에 강점이 있다. 예를 들어 ‘아이폰17 배터리 교체’를 검색한다면 아이폰17과 배터리 교체라는 단어가 정확하게 들어간 문서에 높은 점수를 줄 수 있다.
즉, Dense Embedding이 말은 달라도 뜻을 알아듣는 사람이라면 Sparse Embedding은 정확한 단어에 집중하는 사람이라고 이해하면 된다.
의미를 잘 찾는 Dense Embedding만 사용하면 되는 것 아니냐고 생각할 수 있다.
하지만 의미에만 집중하면 ‘아이폰17 배터리 교체’를 검색했을 때 ‘최신 스마트폰 수리’라는 의미가 비슷하다는 이유로 갤럭시 수리 문서를 가져올 수 있다. 반대로 Sparse Embedding만 사용하면 같은 뜻을 다른 단어로 표현한 문서를 놓칠 수 있다.
그래서 실무에서는 어느 하나만 고정적으로 사용하지 않고 Dense Embedding과 Sparse Embedding을 함께 활용한다. 이를 Hybrid Search라고 한다. 범용적인 문서에서는 의미 검색이 중요하기 때문에 Dense의 가중치를 높게 잡고, 제품명이나 전문 용어가 많은 문서에서는 정확한 단어 검색이 중요하기 때문에 Sparse의 가중치를 높게 잡는 식으로 조정한다.
Vector DB
앞선 임베딩 과정에서 청크를 숫자로 변환했다. 이제 변환한 벡터와 원문을 함께 저장해야 한다.
벡터 DB는 벡터를 저장하고 서로 가까운 벡터를 빠르게 찾도록 만들어진 저장소라고 이해하면 된다.
아주 일반적인 예시로 일반 DB에서 ‘아이폰17’을 검색하면 ‘아이폰17’이라는 단어가 들어간 데이터를 가져온다. 반면 벡터 DB는 의미가 비슷한 ‘아이폰’, ‘애플’, ‘iOS’, ‘스마트폰’과 관련된 내용도 함께 찾을 수 있다.
전용 벡터 DB로는 클라우드 기반의 Pinecone과 RAG에서 많이 사용하는 ChromaDB 등이 있다. Supabase에서도 PostgreSQL에 pgvector를 추가해 일반 데이터와 벡터를 함께 저장하고 검색할 수 있다.
정리하면 벡터 DB는 청크의 원문과 임베딩한 숫자를 함께 저장하고, 사용자 질문과 의미가 가까운 청크를 찾아주는 역할을 한다.
글을 마치며
여기까지 문서를 추출하고 청크로 나눈 뒤 임베딩해 벡터 DB에 저장하는 과정까지 살펴봤다.
다음 글에서는 사용자 질문을 임베딩하고, 관련 문서를 검색하고, 검색 결과를 LLM에 전달해 답변을 만드는 과정을 알아보자.